

OrcaRouter、27Bモデルを12.3GBに圧縮した「OrcaSAQ-2」を公開
公開日:

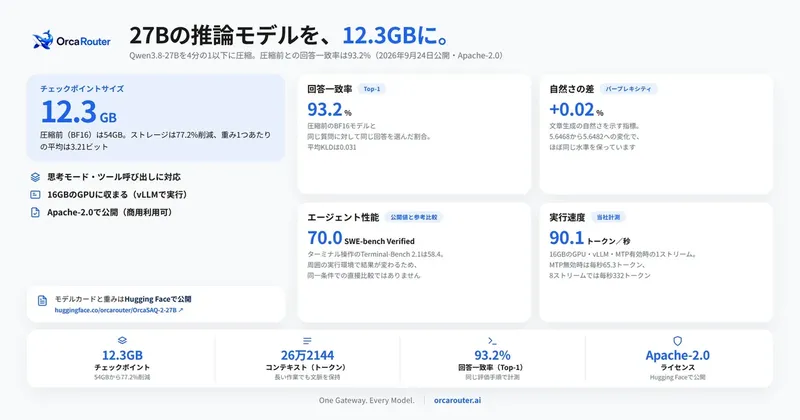
FlashLabsは2026年9月25日、OrcaRouterの研究チームがAIモデル「OrcaSAQ-2 27B」を公開したと発表しました。Qwen3.8-27Bを基に、重みのサイズを54GBから12.3GBへ縮小。圧縮前と同じ次トークンを選ぶ割合は93.2%で、判断が完全に一致するわけではありません。16GBのGPUでも実行できるとしていますが、必要なソフトウェアや扱える文脈長には条件があります。自社環境でAIエージェントを動かしたい開発チームにとって、性能と運用条件を見極める材料になる発表です。
ポイント
- 127Bモデルの重みを54GBから12.3GBに縮小(77.2%減)
- 2圧縮前との次トークン一致率は93.2%。性能が同じとは限らない
- 316GB GPUでも実行可能。vLLM連携と文脈長の設定が必要
圧縮の目的と背景
OrcaSAQ-2 27Bは、Qwen3.8-27Bを基にした量子化モデルです。元のBF16形式の重みは54GBで、GPU1枚での運用には大きな容量が必要でした。今回の重みは12.3GBに縮み、16GB級GPUでの実行を想定します。ただし、重みの容量だけで実行時のメモリ使用量は決まりません。AIエージェントでは一度の判断の違いが後続のツール操作に影響し得るため、圧縮率だけでなく実際の業務タスクでの検証が重要です。
圧縮方式と性能
OrcaRouterの研究チームは、層ごとに精度を変える混合精度の量子化方式「OrcaSAQ2」を使い、重み1つあたり平均3.21ビットに圧縮しました。公開されているのはモデルの重みで、量子化の詳細な手順や精度配分は公開されていません。主な比較値は次のとおりです。
| 指標 | 圧縮前(BF16) | OrcaSAQ-2 27B |
|---|---|---|
| 重みのサイズ | 54GB | 12.3GB |
| 相対サイズ | 100% | 22.8% |
| パープレキシティ | 5.6468 | 5.6482 |
| 次トークンのTop-1一致率 | 100% | 93.2% |
数値は公開元のモデルカードに記載された同一評価手順での比較です。パープレキシティの差は約0.02%ですが、これは下流タスクの性能が同じことを保証しません。SWE-bench Verified 70.0、Terminal-Bench 2.1 58.4も公開元の値です。他社モデルの公開値とは実行環境が異なるため、直接の優劣比較には使えません。
実行環境と提供形式
モデルカードによると、16GB GPU上ではvLLMとOrcaSAQ2対応の連携を使って実行します。15.7GiBのメモリ上限で測った生成速度は、1ストリーム・MTP有効時で毎秒90.1トークン、無効時で65.3トークン、8ストリームでは合計332トークンです。いずれも公開元の測定条件による値で、手元の環境で同じ速度になるとは限りません。
仕様上の最大コンテキスト長は26万2144トークンですが、16GB GPUでの実用的な開始設定は約3万2000トークンとされています。最大長がそのまま16GBに収まるという意味ではありません。入力はテキストのみで、画像には対応していません。重みはApache-2.0ライセンスでHugging Faceに公開されています。
導入時の確認点
FlashLabsは、このモデルを日本の企業や開発者に紹介していくとしています。導入を検討する際は、必要なvLLM連携の入手方法、GPUメモリとコンテキスト長の組み合わせ、実際のコーディング・ツール操作での品質を自社環境で確かめる必要があります。圧縮前との次トークン一致率は93.2%で、判断が完全に同一になるわけではありません。公開値だけで長時間の業務遂行能力やコスト削減効果を断定しないことが大切です。
Q&A
Q. OrcaSAQ-2 27Bは何を公開したモデルですか?
A. Qwen3.8-27Bを量子化した27B規模のテキスト生成モデルです。Hugging Faceで重みがApache-2.0ライセンスで公開されています。量子化手法の詳細は非公開です。
Q. 圧縮前と同じ性能ですか?
A. 同一評価での次トークンのTop-1一致率は93.2%です。パープレキシティの差が約0.02%でも、実際の業務タスクで同じ結果になるとは限りません。
Q. 16GB GPUなら最大26万トークンを使えますか?
A. いいえ。26万2144トークンはモデル仕様上の上限です。公開元は16GB GPUでの実用的な開始設定を約3万2000トークンとしています。vLLMとOrcaSAQ2対応の連携も必要です。
関連リンク
O!Productニュース編集部からのコメント
重みの小型化で試せるGPUの選択肢は広がりそうです。一方、93.2%の次トークン一致率だけでは、長いコーディング作業の成功率は判断できません。導入前に自社のタスクと実行条件で確かめたいところです。
この記事の著者
O!Productニュース編集部


