

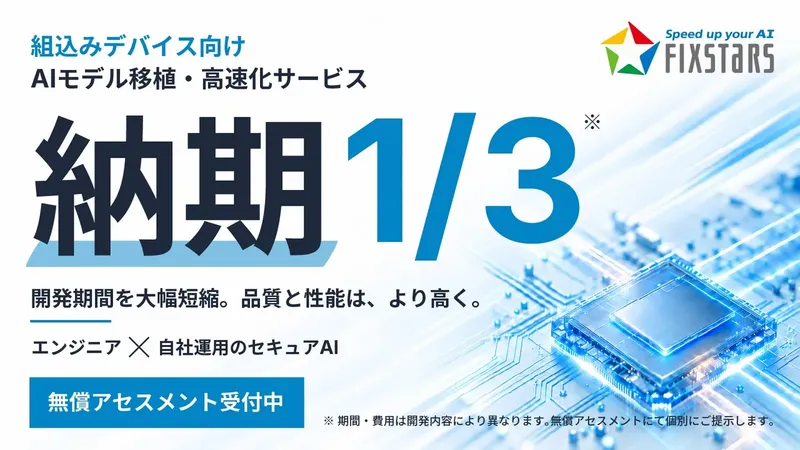
フィックスターズ、組込みAIモデルの移植・高速化受託を開始
公開日:

株式会社フィックスターズは、組込みデバイス向けAIモデルの移植・高速化を支援する受託サービスを開始しました。同社はAI基盤「Fixstars Vega」上のAIエージェントを活用し、従来約6カ月を要した開発を約2カ月で行った事例を紹介しています。開発期間の比較は同社の実績に基づくもので、個別案件の納期を保証するものではありません。自動運転やエッジAIなど、推論処理の高速化を必要とする製品開発が対象です。
ポイント
- 1フィックスターズが組込みAIモデルの移植・高速化サービスを開始
- 2自社AI基盤「Fixstars Vega」を使い開発期間短縮を図る
- 3約6カ月の案件を約2カ月で完了した事例を紹介
サービスの特長
本サービスは、AIモデルやソフトウェアの処理高速化と、各種組込みデバイスへの移植を受託するものです。同社は、従来約6カ月を要した案件を約2カ月で完了した事例を紹介しています。実際の納期は案件の範囲や条件に応じて見積もられます。同社は特急料金を設定せず、開発費用を従来の受託開発と同水準としています。品質面では、網羅的なテストを実施し、性能の最適化を図るとしています。テスト結果やベンチマーク結果、設計ドキュメントも納品されます。
機密保持と提供プロセス
開発に使用するAIエージェントは、フィックスターズが自社内で運用するAI基盤上で動作します。顧客から預かった仕様書やソースコード、データが外部のAIサービスに送信されることはなく、外部AIモデルの学習に使われることもありません。提供プロセスは、無償アセスメントで対象処理や現状性能を確認し、短縮可能な期間と達成可能な性能を試算します。その後、見積り、開発、納品と進み、納品後も継続改善に対応します。
短納期を実現する仕組み
フィックスターズのエンジニアは、AIエージェントと協働して開発を行うエージェンティックエンジニアリングを採用しています。その環境として、オープンウェイトLLMを用いた社内AI基盤「Fixstars Vega」を構築し、その上で高速化・移植に特化したAIエージェント実行環境(ハーネス)を開発しています。ハーネスには、チップごとの最適化パターンや量子化戦略、性能計測のノウハウが実装されており、専門性の高い開発を高品質かつ短納期で実現します。設計や技術判断、コードレビューはエンジニアが実施し、AIの速度とプロの品質を両立させています。
超短納期の開発事例
自動運転AIモデルの推論高速化では、従来約2人月と見積もられた課題に対して、エンジニアがAIエージェントを使用することでわずか1週間で目標速度を達成しました。処理速度は3.95倍に向上し、工数削減効果は最大で約8分の1となりました。アプローチとしては、TensorRT化やPTQ(学習済みモデルの量子化)、カスタムCUDAカーネルのTensorRT Plugin化などが用いられています。
Q&A
Q. 「納期1/3 組込みデバイス向けAIモデル移植・高速化サービス」とは何ですか?
A. 組込みデバイスに搭載するAIモデルやソフトウェアの処理高速化と移植を、開発期間の短縮を目指すフィックスターズの受託サービスです。同社は約6カ月の案件を約2カ月で完成させた事例を示しています。
Q. 開発期間が短縮できるのはなぜですか?
A. フィックスターズが自社運用するAI基盤「Fixstars Vega」上のAIエージェントを活用し、エージェンティックエンジニアリングで開発効率を高めているためです。
Q. 短納期でも費用は高くなりますか?
A. いいえ、特急料金は発生せず、開発費用は従来の受託開発と同水準です。
関連リンク
O!Productニュース編集部からのコメント
開発期間を約6カ月から約2カ月にした事例は、組込みAIの移植を急ぐ製品チームの参考になります。自社案件の期間は見積時に確認したいです。
引用元:PR TIMES
この記事の著者
O!Productニュース編集部


