

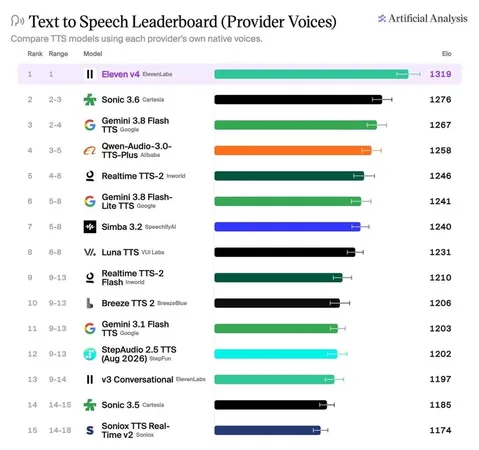
イレブンラボ、感情表現を強化した音声合成モデル「Eleven v4」を提供開始
公開日:

イレブンラボジャパン合同会社は2026年9月29日、新しい音声合成モデル「Eleven v4」の提供を開始しました。文章の文脈や感情を読み取り、声で演じるように話すことができます。同時に、リアルタイム対話向けの低遅延版「Eleven v4 Turbo」も公開しました。動画広告やオーディオブック、多言語コンテンツの制作など、音声表現の幅を広げる選択肢となります。
ポイント
- 1イレブンラボが音声合成モデル「Eleven v4」と低遅延版「Turbo」を提供開始
- 290以上の言語に対応し、日本語の自然なリズムや感情表現を強化
- 3Turboは音声生成開始まで約100ミリ秒、音声エージェント向けに設計
文脈を読み取り、声で演じる音声合成
「Eleven v4」は、文章の文脈や演出意図を捉え、声のトーンや間、感情、キャラクター性を表現します。台本を読み上げるだけでなく、声で演じるためのモデルです。ドラマティックな場面から穏やかな語り、緊迫したせりふ、コミカルな掛け合いまで、同じ声のまま場面に応じた幅広い表現ができます。環境音や効果音もインラインタグで演技に組み込めます。たとえば「[door slams]」や「[rain]」などを台本に指定すると、場面に合わせた音を生成できます。
感情やテンポをテキストで直接指定
台本の中に「インラインタグ」を書くことで、感情、テンポ、間、リアクション、効果音を直接指定できます。「[laughs]」「[whispers]」「[long pause]」といったタグを1つのせりふに複数連ねた場合でも、イレブンラボは前モデルの「Eleven v3」より安定して反映できると説明しています。制作の途中で1文だけ作り直す機能もあり、同社は前後の音声になじみやすいとしています。発音記号(IPA)への対応も改善し、読み方の難しい固有名詞や人名の発音を調整しやすくなりました。
日本語の表現力と多言語展開を強化
「Eleven v4」は90以上の言語に対応します。日本語は、ブラジルポルトガル語、標準中国語、広東語などとともに、前モデルからの品質改善に重点を置いた言語のひとつです。イレブンラボは、発音だけでなくリズム、感情、話し方の自然さも改善したと説明しています。声の特徴を維持しながら、台本の言語に合わせた話し方で音声を生成する設計です。たとえば日本語の音声を基に英語の台本を読ませる場合も、英語らしい発音に近づけます。ただし、結果は元の音声や対象言語によって異なります。
リアルタイム対話向けの「Eleven v4 Turbo」
「Eleven v4 Turbo」は、Eleven v4の表現力を低遅延で利用できるモデルです。最初の音声が出るまでのモデル推論時間は中央値で約100ミリ秒で、通信や大規模言語モデルによる回答生成の時間は含みません。顧客サポート、予約、営業などの音声エージェントやライブアシスタントでの利用を想定しています。大規模言語モデルが回答を生成している途中からテキストを順次流し込んで音声化を始められるため、応答の待ち時間を短くできます。提供開始の初日から『ElevenAgents』で利用できます。通話の途中で相手が話す言語を切り替えても、同じ声のまま切り替わった言語で応対を続けます。
ボイスクローンと長尺コンテンツの品質向上
話者の声を再現するボイスクローン機能も向上しました。短い音声サンプルから声を再現する「インスタントボイスクローン」では、約10秒の音声からでも声質や話し方の特徴をこれまで以上に忠実に捉えられるようになりました。また、話者の声をより精緻に再現する「プロフェッショナルボイスクローン」も引き続き利用できます。オーディオブックやポッドキャストなどの長尺コンテンツでは、複数回に分けて音声を生成した際に声質や話し方にばらつきが生じることがありましたが、「Eleven v4」では複数回の生成をまたいでも声や話し方の印象を保ちやすくなり、一貫性のある音声を制作できます。
Q&A
Q. Eleven v4とは何ですか?
A. イレブンラボの音声合成モデルです。文章の文脈や演出意図に応じて、声のトーンや間、感情表現を調整できます。
Q. Eleven v4 Turboの「約100ミリ秒」は何の時間ですか?
A. 最初の音声が出るまでのモデル推論時間の中央値です。通信や大規模言語モデルによる回答生成は含みません。顧客サポートや予約などの音声エージェント向けです。
Q. 日本語の音声は何が変わりましたか?
A. イレブンラボは、発音に加え、リズムや感情、話し方の自然さを改善したと説明しています。品質は元の音声や用途によって異なるため、利用前の確認が必要です。
関連リンク
O!Productニュース編集部からのコメント
低遅延版は、音声エージェントの多言語応対に使う設計です。「約100ミリ秒」は音声生成のモデル推論時間で、実際の通話応答には通信や回答生成の時間も加わります。導入時は利用環境での応答時間を確認したいところです。
引用元:PR TIMES
この記事の著者
O!Productニュース編集部


